A tecnologia nunca pára, e nós também não
Plataformas Mini-ITX validadas, concebidas para uma implementação fiável em ambientes de sistemas industriais, periféricos e incorporados.

NPU da Intel · AMD Ryzen AI · NVIDIA Jetson · GPU discreta
Escolha a arquitetura de IA com base no tamanho do modelo, na compatibilidade com aceleradores, na memória, nas entradas/saídas dos sensores, no tempo de execução, no consumo de energia e nas características térmicas.

Seleção da plataforma de IA
Comece pelos limites do modelo, do tempo de execução, do caminho de dados e da implementação — e não pelos valores de TOPS apresentados nos títulos.
Escolha o Intel Core Ultra ou o AMD Ryzen Embedded 8000 para aplicações x86 com aceleração NPU local.
Opte pelo NVIDIA Jetson quando o CUDA/TensorRT, o JetPack, a captura de imagens de câmara ou a robótica forem elementos determinantes do sistema.
Escolha uma placa Mini-ITX com slot PCIe x16 compatível com GPU quando o modelo necessitar de mais VRAM ou de uma GPU substituível.
Utilize aceleradores de complementos apenas depois de terem sido comprovados o tempo de execução, a largura de banda, os controladores, a alimentação e a cobertura do operador.
Explorar placas Mini-ITX com IA de ponta e alto desempenho →
Plataforma · Opções de configuração
O acelerador é apenas uma parte do sistema. A memória, as entradas/saídas (I/O), o ambiente de execução, a PCIe, o armazenamento, a rede, a alimentação e a refrigeração determinam se ele funciona na prática.
| Orientação em IA | Plataforma Representativa | Melhor ajuste | Prioridade ao nível do Conselho de Administração |
|---|---|---|---|
| NPU Intel integrada | Core Ultra 5 125H · CPU + GPU Arc + Intel AI Boost | HMI industrial, visão computacional, inferência x86, cargas de trabalho mistas de CPU/GPU/NPU | Memória, OpenVINO, câmara/caminho de dados, PCIe/M.2, alimentação, refrigeração. |
| NPU AMD integrada | Ryzen Embedded 8840U · Zen 4 + Radeon + NPU XDNA | Sistemas x86 incorporados de IA, visão computacional, análise de dados e com gráficos avançados | DDR5/ECC, Ryzen AI, encaminhamento PCIe, E/S de sensores, gestão térmica. |
| NVIDIA Jetson | Jetson Orin Nano / NX / AGX Orin | Robótica, IA com múltiplas câmaras, CUDA/TensorRT, fusão de sensores | Módulo Exact, JetPack, E/S CSI/USB/rede, NVMe, modo de alimentação, refrigeração. |
| GPU discreta | Mini-ITX com slot PCIe x16 compatível com GPU | Modelos de maiores dimensões, maior necessidade de VRAM, plataformas de GPU para computadores de secretária | Mapeamento PCIe, dimensão da GPU, fonte de alimentação, potência do slot, fluxo de ar, recursos partilhados. |
Comparar plataformas de referência para arquiteturas de IA →
Especificações principais
Estes valores utilizam diferentes âmbitos de acelerador e não constituem uma classificação de desempenho.
| Plataforma de referência | Métrica de IA | Memória / Largura de banda | Referência de potência | Expansão / E/S | Tempo de execução primário |
|---|---|---|---|---|---|
| Intel Core Ultra 5 125H | NPU 11 TOPS INT8; pico total de 33 TOPS INT8 | Suporte para a classe DDR5 / LPDDR5; a topologia da placa varia | 28 W de potência nominal; 115 W de potência máxima em modo turbo | Até 28 pistas PCIe do processador | OpenVINO, ONNX Runtime, DirectML / Windows ML |
| AMD Ryzen Embedded 8840U | NPU XDNA com capacidade até 16 TOPS | DDR5-5600; ECC de canal duplo | TDP de 15–30 W | 20 vias PCIe Gen4 | Caminhos do software Ryzen AI / ONNX Runtime |
| Jetson Orin Nano 8 GB Super | 67 esparsos / 33 densos INT8 TOPS | 8 GB de LPDDR5; 102 GB/s | Modos de 7 / 15 / 25 W + MAXN Super | Câmara com placa de suporte, NVMe, USB, rede, PCIe | JetPack, CUDA, TensorRT |
| Percurso da GPU discreta | Depende da GPU selecionada, da precisão, da dispersão e do tempo de execução | VRAM da GPU + memória do sistema | Carga da GPU + CPU + placa-mãe + periféricos | O mapeamento PCIe x16 e o espaço livre no chassis dependem do sistema | Depende do fabricante da GPU e do framework |
Aplicações
Escolha com base no número de câmaras, na resolução, no pré-processamento, na precisão do modelo, na latência de ativação e na capacidade de inspeção.
A fusão de sensores, a perceção, a navegação, os circuitos de controlo e a latência costumam favorecer o Jetson ou um acelerador mais potente.
As NPUs x86 integradas são adequadas para sistemas Windows/Linux que combinam gráficos, E/S industrial e inferência local moderada.
O tamanho do modelo, a quantização, a RAM/VRAM, a cache KV, o tempo de execução, os tokens por segundo, o armazenamento e a carga térmica determinam se o Jetson ou uma GPU discreta é a opção mais adequada.
Arquitetura · Implementação técnica
Uma placa preparada para IA deve suportar, em simultâneo, a recolha de dados, a inferência, a saída de dados e a refrigeração.
Principais considerações de engenharia
Limites de engenharia · Validação
| Área de reclamações | O que isso significa | O que o Sistema Real Tem de Provar |
|---|---|---|
| TOPS | Rendimento máximo do acelerador numa condição de teste definida. | Meça os FPS, a latência ou os tokens/s com a precisão de produção, o pré-processamento, o tráfego de memória e as frequências sustentadas. |
| NPU integrada | Um acelerador integrado no pacote do processador. | O modelo de destino deve corresponder aos operadores suportados; as tarefas não suportadas poderão ser executadas na CPU ou na GPU. |
| Ranhura PCIe x16 | Uma interface mecânica de expansão da GPU. | Verifique a largura da via, a geração, a potência da ranhura, o tamanho da GPU, a fonte de alimentação, o fluxo de ar e os recursos M.2/NIC partilhados. |
| Número de interfaces de câmara | Recursos CSI, USB ou de rede disponíveis. | As transmissões simultâneas dependem também de canais, hubs, ISP/decodificação, largura de banda de memória, armazenamento, sincronização e controladores. |
| Funcionamento da IA sem ventoinha | Arrefecimento sem ventoinha do sistema numa configuração definida. | Validar em conjunto as condições ambientais, do invólucro, do dissipador de calor, da carga sustentada do acelerador, do calor de armazenamento/NIC e da regulação de potência. |
Guia de Seleção
| Requisito principal | Ponto de partida recomendado | Considere outra arquitetura quando |
|---|---|---|
| Software x86 + IA moderada + OpenVINO | Plataforma Intel Core Ultra NPU | A cobertura da operadora, a memória ou a largura de banda são insuficientes. |
| IA x86 + placa gráfica Radeon + NPU XDNA | Plataforma AMD Ryzen Embedded 8000 | A carga de trabalho requer CUDA/TensorRT ou mais memória do acelerador. |
| CUDA/TensorRT, câmaras, robótica, IA de ponta | NVIDIA Jetson | O modelo necessita de mais VRAM, hardware de GPU substituível ou x86. |
| Modelos de grandes dimensões / GPU de secretária substituível | Mini-ITX compatível com GPU discreta | O tamanho da GPU, a potência do slot, a fonte de alimentação, o fluxo de ar ou a caixa não são compatíveis. |
| Acelerador ainda não selecionado | Faça primeiro o benchmark do modelo real | Só deve ser selecionado depois de se terem medido a latência, a precisão, a memória, o consumo de energia, o desempenho do caminho de dados, a compatibilidade em tempo de execução e o custo do sistema. |
Revisão da configuração da IA
Envie o modelo, a precisão, o objetivo de latência/FPS, o acelerador, as câmaras ou sensores, a memória, o armazenamento, a rede, o tempo de execução, a potência, a caixa, a temperatura e a quantidade.
Produtos recomendados · Plataformas de referência
Comece pela arquitetura mais próxima e, em seguida, verifique o processador/módulo exato, as entradas e saídas (I/O), o tempo de execução, a potência, os componentes mecânicos e o sistema de refrigeração.
| Plataforma de partida | Cargas de trabalho mais adequadas | Verificar antes da publicação |
|---|---|---|
| Intel Core Ultra Mini-ITX para IA de ponta | CPU/GPU/NPU x86 para inferência local, visão, HMI e cargas de trabalho mistas. | CPU, memória, câmara/caminho de dados, OpenVINO, M.2/PCIe, alimentação, BIOS, refrigeração. |
| Placa de suporte NVIDIA Jetson Mini-ITX | JetPack/CUDA/TensorRT para robótica, visão computacional, fusão de sensores e IA na periferia. | Módulo Jetson, E/S CSI/USB/rede, NVMe, BSP, modo de alimentação, refrigeração, revisão da placa de suporte. |
| Mini-ITX compatível com GPU com PCIe x16 | GPU discreta substituível para modelos maiores, mais VRAM ou cargas de trabalho mais exigentes. | Mapa PCIe, dimensões da GPU, potência da fonte de alimentação/slot, fluxo de ar, combinação com a CPU, recursos partilhados, espaço livre no chassis. |
Personalização · Apoio técnico
Personalize a placa quando a carga de trabalho exigir entradas/saídas de sensores, encaminhamento do acelerador, software, alimentação, refrigeração ou componentes mecânicos diferentes.
NPU integrada, módulo Jetson, GPU PCIe, acelerador M.2, encaminhamento de vias, alimentação e estratégia de substituição.
CSI, USB, GigE, disparo/sincronização, CAN, GPIO, LiDAR, 10GbE, PoE e disposição dos conectores.
Runtime, BSP, controladores, contentores, arranque seguro, OTA/recuperação e fixação de versão.
Intervalo de entrada, proteção, modo de alimentação, carga de arranque, arrefecimento, espaço livre para a GPU e controlo da lista de materiais (BOM).
Base de referência técnica
FAQ
Não existe um valor-alvo universal para o TOPS. Compare o modelo real com a precisão pretendida, o tempo de execução, o valor-alvo de latência/FPS, o modo de consumo energético e as condições térmicas sustentadas.
Escolha com base na compatibilidade com modelos, RAM/VRAM, conjunto de software, E/S de sensores, latência, consumo de energia, gestão térmica e necessidades de atualização.
Não. O FPS e a latência também dependem dos operadores, da precisão, da largura de banda da memória, do pré-processamento, da eficiência de execução, do modo de consumo de energia e da limitação de desempenho.
Sim, desde que a placa disponha de interfaces CSI, USB ou de rede adequadas e de capacidade suficiente em termos de descodificação, memória, sincronização, alimentação e dissipação térmica.
Sim. Fixe o sistema operativo/BSP, os controladores, o ambiente de execução, os contentores, o OTA/recuperação, a versão do modelo e a revisão do hardware e, em seguida, realize testes de regressão na carga de trabalho de produção.
Mantenha-se informado com conhecimentos práticos de design criados em torno da implantação de IA no mundo real na borda. O nosso conteúdo editorial analisa a seleção de NPUs, a otimização de pipelines de visão, o ajuste de E/S para sensores ML e a gestão de placas de IA críticas para o ciclo de vida. Quer esteja a desenvolver sistemas de controlo robótico, unidades de inspeção autónomas ou terminais de visão compactos, o nosso blogue fornece aos compradores técnicos e às equipas de engenharia a orientação de que necessitam para construir sistemas prontos para IA que funcionam sob pressão.
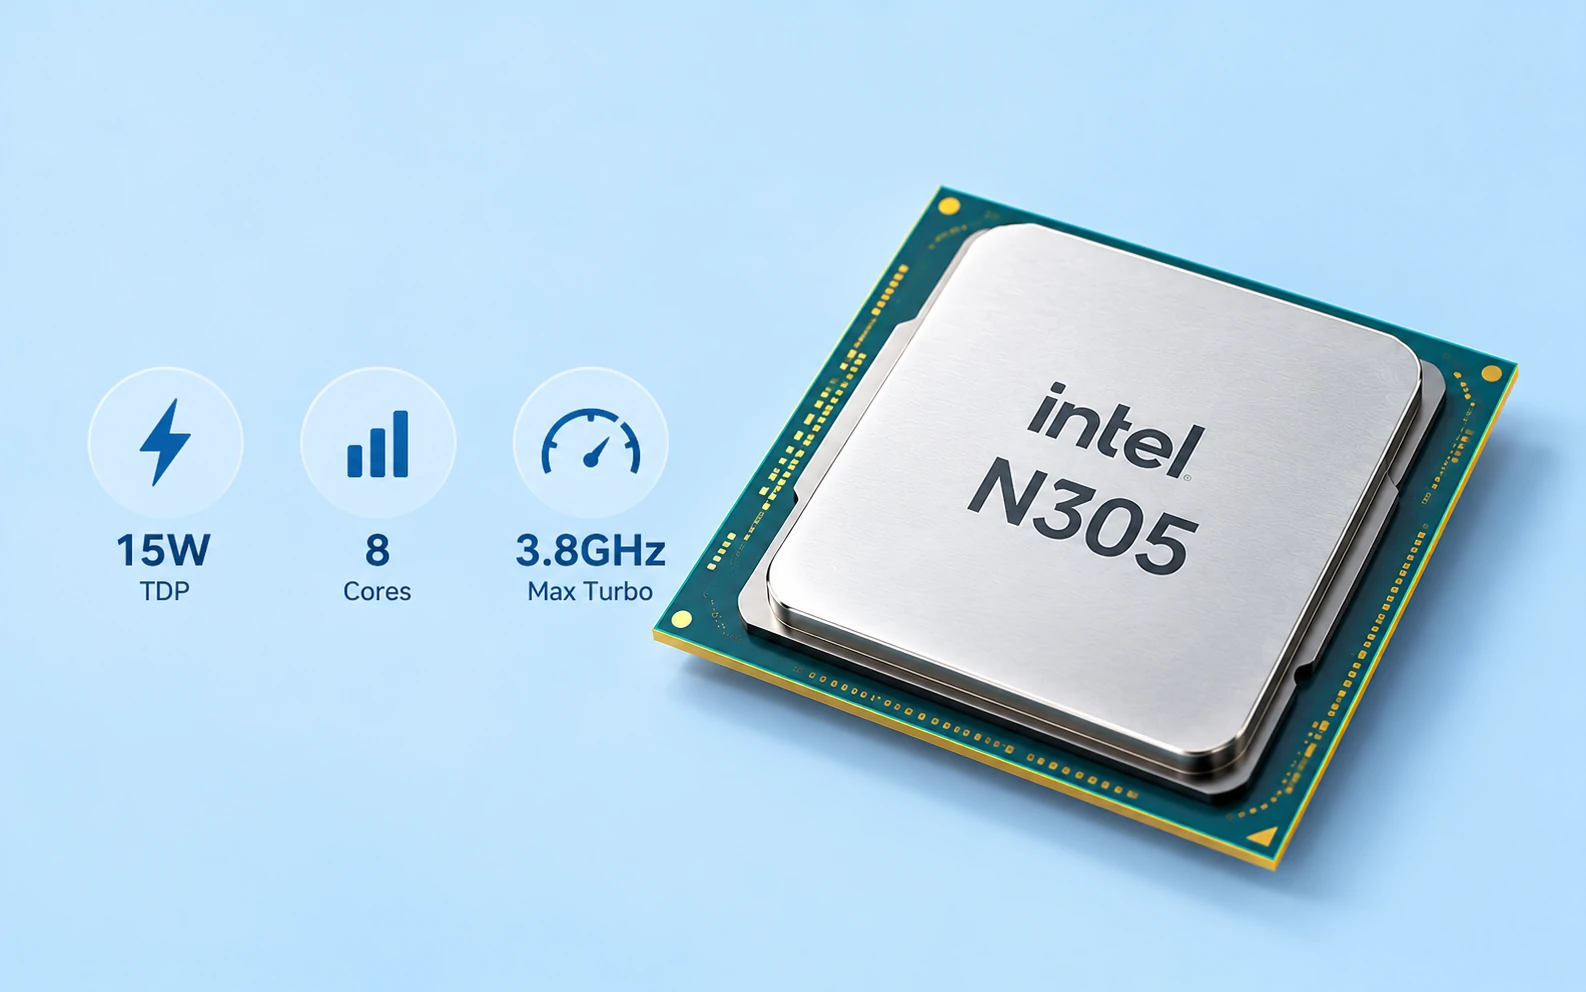
O consumo de energia do Intel N305 depende da configuração completa do hardware. Embora o Core i3-N305 tenha um TDP nominal de 15 W, estudos independentes…

Comparação entre processadores X86 e ARM para determinar qual é o melhor para as suas necessidades. Saiba mais sobre as diferenças e vantagens dos...

LTE vs 4G não é uma comparação entre duas redes móveis completamente distintas. O 4G descreve uma geração de comunicações móveis,…
